
产线光开关端口不够用?非对称矩阵定制与级联避坑
发布时间:2026-10-22 | 作者:能光智翼技术支持团队
最后更新:2026-10-23
在实际去产线调研时,经常会遇到一个很尴尬的现象:真实的测试线,往往长得并不标准。
比如,产线上刚好只有 12 个老化槽位需要接线,但工位上摆着 3 台 DCA 和 2 台光谱仪。你心里想要的是一个 12×5 的矩阵,但翻遍各大厂商的选型手册,标准品只有规规矩矩的 8×8 或者 16×16。
买 8×8 吧,槽位不够用;买 16×16 吧,多出来的端口全在那儿吃灰,老板看预算表肯定要骂人。这时候,很多工程师脑子里冒出的第一个念头是:“要不买两台 8×8 的标准品,自己级联串起来用?”
听我一句劝,这个想法很危险。
为什么两台 8×8 串联,不等于一台 16×8?
从数学上看,8+8=16 没毛病。但从光路和工程的角度看,级联是个妥妥的“坑”。
第一是插损直接翻倍。光从第一台 8×8 切进去,过内部光路,出端口,走一根跳线,再进第二台 8×8,再切出来。中间必然经历了两次内部切换和一次外部对接。本来单台设备的插损是 0.8dB,两台串下来,直接飙到 1.5dB 以上。如果你测的是高速光模块,这多出来的 0.7dB 损耗可能直接吃掉了系统的功率余量,导致测试数据一直卡在及格线边缘。
第二是控制逻辑极其反人类。两台独立设备,意味着你的上位机测试软件要发两条指令。如果想把槽位 3 切到 DCA 5,你得先在软件里算清楚:进第一台的几号口,出第一台的几号口,再进第二台的几号口。产线排程一复杂,极其容易切错光路,查起故障来更是要命。
最务实的解法:直接上 16×8 非对称矩阵,降维覆盖
遇到这种 12 个槽位配 5 台仪器的需求,懂行的工程师都知道,去市面上满世界找“纯物理 12×5”的定制是没有意义的。
因为上游的光开关底层器件,阵列规格都是基于 2 的 N 次方(4、8、16、32)来做的。整机厂商如果要满足你的需求,最合理的做法就是直接拿标准的 16×8 非对称矩阵架构来打底。
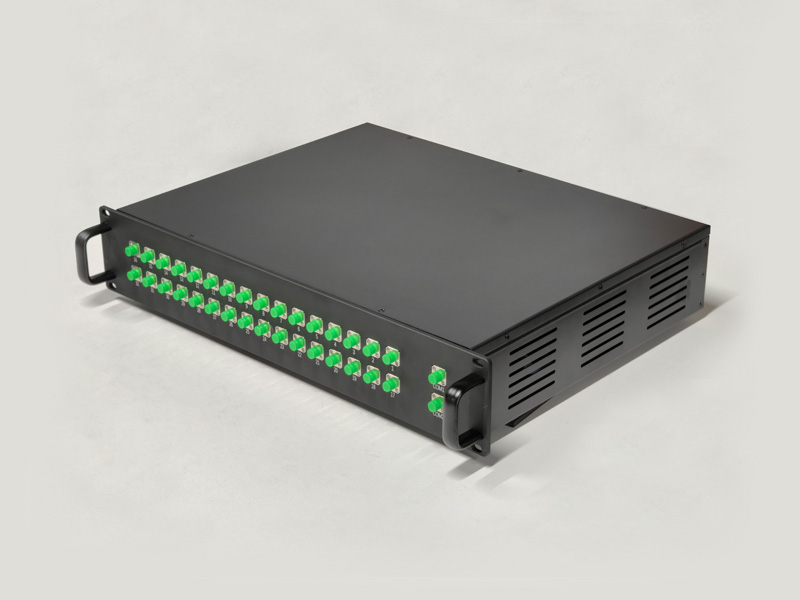
交到你手里的设备,内部走纤和熔接就是 16×8 的拓扑,但输入端你只接 12 路,输出端只接 5 路,剩下的端口在软件里设空或者留作备用。
为什么这才是最优解?
直接消灭了级联损耗:光进去,过内部一次切换就出来了,不用在外面走跳线串联,保住了极其珍贵的测试功率余量。
控制代码极简:你的上位机不需要去算复杂的级联路径,底层驱动直接配好映射。发一条指令:“槽位 1 连通仪器 2”,一步到位。
成本反而更低:大厂的标准品 16×8 是流水线批量出货的。你直接买一台 16×8,比你要求厂商重新画图纸、单独去拼凑一个 12×5 的奇葩阵列,交期要快得多,价格也更透明。
这种“用标准底层架构,去降维覆盖非标端口需求”的行业常识,很多时候供应商是不会主动跟你说的。但我们一直觉得,做设备集成,就是要把复杂的内部拓扑留给自己,把最简单、最标准的接口交付给客户。
那级联这招,什么时候能用?
级联不是完全不能用,但要换个思路,用在物理隔离和主备切换上。
比如,把高频测试的 6 个核心工位接在 A 矩阵上,把低频的抽检工位接在 B 矩阵上。平时两边各干各的,只有当 A 矩阵的某台 DCA 宕机,或者需要跨区域借用仪器时,才通过中间的一根光纤跳线把两个矩阵连起来。这叫“做区域划分”,而不是单纯为了扩充端口。
定制非标矩阵,交期和图纸要注意什么?
既然决定定制,有几件事必须在签合同前跟供应商的工程对齐:
内部应力释放:非对称矩阵因为端口数量不对等,内部盘纤的路径长短不一。如果出厂前的应力释放工艺做得不到位,以后产线高低温一跑,插损马上就会漂移。这也是为什么全熔接设备特别考验出厂工艺。
物理接口的排列:输入和输出端口,到底是全排在前端面板,还是前后分开出纤?这直接决定了你在机柜里理线会不会打架,别等设备到了才发现线插不进去。
交期权衡:标准品可能一周就发货,非对称定制因为要重新排产,一般需要 3-4 周。你的产线规划进度必须把这个时间差算进去。
说在最后
测试线的架构没有一模一样的,买一台能严丝合缝嵌进你测试流程里的非标设备,比买一台高端但用不上的标准品有意义得多。
如果你现在正对着产线的工位图发愁,卡在端口配比怎么定、级联怎么走线,可以把你的工位数量和仪器型号发给我,我们直接帮你画一版非标定制的光路拓扑图,看看能不能把成本砍下来。